
打印机报修资料实操:分开查看PDF字段与页面内容
2026-11-03
打印机报修资料实操:分开查看PDF字段与页面内容
一份打印机报修PDF在阅读器里显示了姓名栏、设备栏和问题说明,接手人员却从字段提取工具中看不到相同内容。这未必说明附件丢了信息,页面文字和交互表单字段本来就是需要分开观察的对象。下面介绍只读整理方法,不填写原件,不运行附件中的脚本,也不假设已经取得任何客户的真实报修文件。
保留原始附件,先记录看到的页面状态
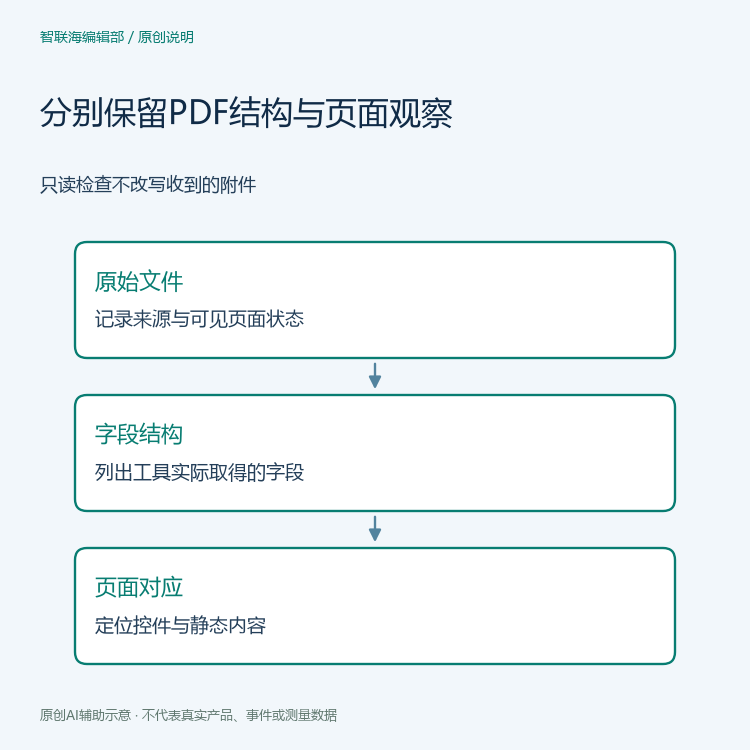
登记文件来源、版本、接收时间及阅读工具,保留未改写原件。使用获准的工作副本,观察所讨论内容位于哪一页、哪个区域,显示为文字、图像还是可交互控件。截图可帮助定位,但应说明它只覆盖当时可见部分,不能让一张局部截图代替整份文件的结构说明。
报修资料可能带有联系人、序列号或其他受限信息。整理和外发时遵守既有权限,保留有权限原件,对共享副本作明确脱敏,不把真实附件上传到不明在线转换服务。若文件需要授权才能读取,应通过提供方正常取得访问条件,不能把访问失败写成字段为空。
只读查看文档中的表单字段
pypdf的get_fields接口说明介绍了从含有交互表单字段的PDF提取字段数据,并说明不能定位字段时的返回情况。技术人员可据适用接口记录字段名、类型和相关信息,保留工具版本及其支持范围。提取结果是结构观察,不是对报修内容真实性的验证。
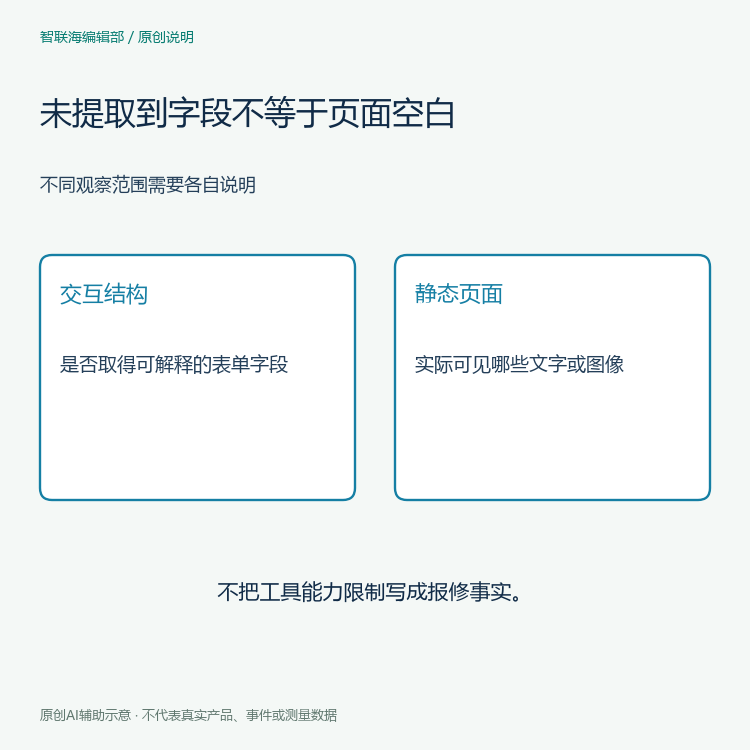
未提取到交互字段,不等于页面没有文字,也不等于使用者没有填过资料。内容可能已经成为静态页面的一部分,或者当前工具不能解释相关结构。应把“未取得字段结构”与“页面可见什么”分别登记,不用一个空结果推断所有记录均为空白。
把页面控件位置与字段清单对应起来
PyMuPDF的页面widgets接口说明提供了查看页面表单控件的能力。若采用这类只读检查,应记录页序、控件位置及其与字段的关系,让接手人员能够回到同一处观察。文档层面的字段清单和页面层面的控件位置,不宜简单假定为逐项一对一。
同一内容可能出现在多个页面位置,部分字段也可能没有当前可见控件。遇到对应不清时,保留实际提取到的标识和页面定位,再请求熟悉文件结构的人员解释。不要为了让清单整齐而随意改名、合并条目或将一个可见值复制到多个没有依据的字段中。
检查静态内容时,保留另一套依据
对没有交互字段却包含静态文字或扫描内容的页面,应按实际文档形式进行阅读和必要复核。文本提取与图像阅读可能呈现不同内容,识别结果也不能自动替代原图。记录看到的内容、提取方式和未能确认的部分,避免让结构工具的限制成为错误的资料结论。
如果提供方交付的是填表后的展平副本,应保留该说明及原始交付关系,而不是认定它仍能以表单方式继续编辑。需要可填写版本时,正常请求相应文件。整理者不应在一份只用于归档的附件上重新创建字段,再把新文件标为未经改动的原件。
交接字段观察与报修事实时分清角色
交接材料可包含文件标识、工具、字段清单、页面位置和静态内容观察,分别注明完成范围。实际故障描述应对应提供者和来源;字段存在、能够读取或页面显示清楚,都不能直接证明维修已经完成。后续收到修订附件时,保留新旧文件身份,重新对应受影响的位置。
两张配图为原创AI辅助方法示意,没有真实客户字段或报修页面。更多资料见三维打印设备报修栏目和文章目录。将PDF字段、页面控件和静态内容分开检查,可以让不同工具的结果得到合理解释,也为负责人员继续核对报修事实留下清楚依据。


